UTF-8 и UTF-16: как решать — ОГЭ по информатике

ОГЭ Информатика сложность в тренажёре: базовая

Имя файла занимает 108 байт в кодировке UTF-16 и 97 байт в кодировке UTF-8. Оно состоит только из русских и латинских… UTF-8 и UTF-16 — ОГЭ по информатике, тема «Кодирование текста и объём сообщения». Ответ проверяется на странице, разбор — сразу.

Пример 1

Имя файла занимает 108 байт в кодировке UTF-16 и 97 байт в кодировке UTF-8. Оно состоит только из русских и латинских букв, цифр и пробелов. В кодировке UTF-16 каждый такой символ занимает 2 байта, а в кодировке UTF-8 русская буква занимает 2 байта, латинская буква, цифра и пробел — 1 байт. Маркер порядка байтов (BOM) не учитывается. Сколько русских букв в нём?

Ответ и разбор

Ответ: 43

Решение

  1. В UTF-16 каждый символ занимает 2 байта, поэтому символов 108 : 2 = 54.
  2. Если бы каждый из 54 символов занимал в UTF-8 1 байт, вышло бы 54 байта, а их 97: каждая русская буква добавляет ещё 1 байт, поэтому русских букв 97 − 54 = 43.

Проверка: 43 русские буквы по 2 байта и 11 остальных символов по 1 байту — 86 + 11 = 97. Число 54 — это все символы, а не только русские буквы.

Ответ: 43.

Нашли ошибку? Напишите нам, код задания: oge-informatics-utf8-i-utf16-unxxtp

Ещё задания этого вида — ниже. Открыть тренажёр

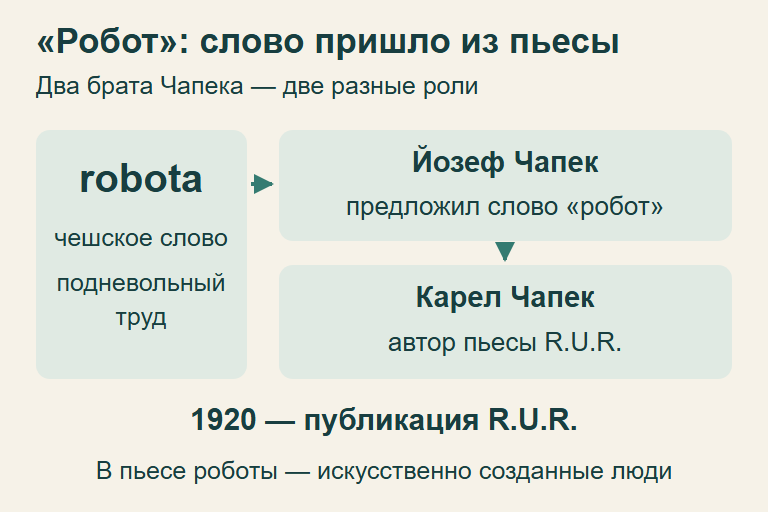
Слово «робот» вошло в мировую культуру через пьесу Карела Чапека R.U.R., опубликованную в 1920 году. Название предложил его брат Йозеф, опираясь на чешское robota — подневольный труд. В пьесе роботы — искусственно созданные люди.

Разобранный пример

Сообщение в чате занимает 184 байта в кодировке UTF-16 и 115 байт в кодировке UTF-8. Оно состоит только из русских и латинских букв, цифр и пробелов. В кодировке UTF-16 каждый такой символ занимает 2 байта, а в кодировке UTF-8 русская буква занимает 2 байта, латинская буква, цифра и пробел — 1 байт. Маркер порядка байтов (BOM) не учитывается. Сколько русских букв в нём?

Ответ: 23

Решение

В UTF-16 каждый символ занимает 2 байта, поэтому символов 184 : 2 = 92.
Если бы каждый из 92 символов занимал в UTF-8 1 байт, вышло бы 92 байта, а их 115: каждая русская буква добавляет ещё 1 байт, поэтому русских букв 115 − 92 = 23.

Проверка: 23 русские буквы по 2 байта и 69 остальных символов по 1 байту — 46 + 69 = 115. Число 92 — это все символы, а не только русские буквы.

Ответ: 23.

Нашли ошибку? Напишите нам, код задания: oge-informatics-utf8-i-utf16-1yc7z1

Формулы и приём

Объём текста при фиксированном коде

Как найти объём текста, если все символы кодируются одинаковым числом бит?

I = K · i

I
объём кодов всех символов сообщения, бит
K
количество символов, включая учитываемые условием пробелы и знаки, символов
i
фиксированное число бит для одного символа, бит на символ

Формула применяется к равномерному посимвольному коду. Сжатие, заголовки и другие служебные данные в этом расчёте отсутствуют.
Пример: сообщение «код и шифр» записано без кавычек и перевода строки; по условию каждый символ, в том числе пробел, занимает 16 бит. Символов 3 + 1 + 1 + 1 + 4 = 10: восемь букв и два пробела. Объём I = 10 · 16 = 160 бит, или 160 / 8 = 20 байт.
Ответ: 20 байт.

Ловушка: пробел тоже символ. Нельзя считать, что любой реальный текст всегда занимает 8 или 16 бит на символ: например, в UTF-8 длина кодирования переменная. Фиксированную длину должен задавать формат или условие.

Ещё примеры

Пример 2

Сообщение в чате занимает 178 байт в кодировке UTF-16 и содержит 73 русские буквы. Оно состоит только из русских и латинских букв, цифр и пробелов. В кодировке UTF-16 каждый такой символ занимает 2 байта, а в кодировке UTF-8 русская буква занимает 2 байта, латинская буква, цифра и пробел — 1 байт. Маркер порядка байтов (BOM) не учитывается. Сколько байт оно займёт в кодировке UTF-8?

Ответ и разбор

Ответ: 162

Решение

  1. В UTF-16 каждый символ занимает 2 байта, поэтому символов 178 : 2 = 89.
  2. В UTF-8 каждый символ занимает хотя бы 1 байт, а русская буква — на байт больше (2 байта): 89 + 73 = 162.

Ответ: 162.

Нашли ошибку? Напишите нам, код задания: oge-informatics-utf8-i-utf16-19ilkmo

Пример 3

Имя файла занимает 264 байта в кодировке UTF-16 и содержит 97 русских букв. Оно состоит только из русских и латинских букв, цифр и пробелов. В кодировке UTF-16 каждый такой символ занимает 2 байта, а в кодировке UTF-8 русская буква занимает 2 байта, латинская буква, цифра и пробел — 1 байт. Маркер порядка байтов (BOM) не учитывается. Сколько байт оно займёт в кодировке UTF-8?

Ответ и разбор

Ответ: 229

Решение

  1. В UTF-16 каждый символ занимает 2 байта, поэтому символов 264 : 2 = 132.
  2. В UTF-8 каждый символ занимает хотя бы 1 байт, а русская буква — на байт больше (2 байта): 132 + 97 = 229.

Ответ: 229.

Нашли ошибку? Напишите нам, код задания: oge-informatics-utf8-i-utf16-4p4aaz

Пример 4

Имя файла занимает 226 байт в кодировке UTF-16 и содержит 53 русские буквы. Оно состоит только из русских и латинских букв, цифр и пробелов. В кодировке UTF-16 каждый такой символ занимает 2 байта, а в кодировке UTF-8 русская буква занимает 2 байта, латинская буква, цифра и пробел — 1 байт. Маркер порядка байтов (BOM) не учитывается. Сколько байт оно займёт в кодировке UTF-8?

Ответ и разбор

Ответ: 166

Решение

  1. В UTF-16 каждый символ занимает 2 байта, поэтому символов 226 : 2 = 113.
  2. В UTF-8 каждый символ занимает хотя бы 1 байт, а русская буква — на байт больше (2 байта): 113 + 53 = 166.

Ответ: 166.

Нашли ошибку? Напишите нам, код задания: oge-informatics-utf8-i-utf16-1xdsbyl

Рядом

Продолжить тренировку

Откройте тренажёр, чтобы решать похожие задания и отслеживать прогресс по темам. Для тренажёра нужен вход; на этой странице вход не нужен.

Задание в формате экзамена с разбором

Родителю

Приложение — для ученика. Родителю ставить его не нужно: кабинет родителя открывается в браузере. Родитель видит фактическую активность, регулярность и повторяющиеся ошибки. Проверять решения самостоятельно не требуется.